Unsere eigene KI. Auf dem Laptop. Ohne Cloud.
Benchmark v2 ist eine KI-Umgebung, die ich selbst entwickelt habe, vom Orchestrator, der für jede Aufgabe das passende Sprachmodell wählt, bis zur eigenen Textverarbeitung.
Jens Ferner · Rechtsanwalt und Softwareentwickler · Alles läuft auf eigenen Rechnern, und kein Wort verlässt das Haus.
benchmark --status
orchestratoraktivwählt für jede Aufgabe das passende Modell
pförtneraktivprüft jede Anfrage, bevor ein Modell sie sieht
verbund3 MacsM5 Pro 48 GB · M1 Pro 16 GB · M1 16 GB
modelle291gemessen in 3.720 Läufen · 50 Familien
eigene5selbst trainiert: die Ferner-LLM-Familie
cloud0 Bytenichts verlässt den Rechner
✓ bereit.
700.000+Zeilen Code in 15 Werkzeugen
291Sprachmodelle gemessen
3.720Messläufe auf 3 Macs
0Byte Daten in die Cloud
Die Idee
Aus einem Test wurde ein Dirigent.
Ziel sind echte KI-Lösungen auf Consumer-Hardware, ohne Rechenzentrum, Abo oder Datenabfluss, und der Weg dahin führte über Messungen.
So läuft eine Anfrage
- Jura
- Zusammenfassen
- Übersetzen
- Stil
Consumer-Hardware
16 GB reichen. 48 GB fliegen.
Dasselbe Modell auf drei Macs, gemessen in Token pro Sekunde (Tok/s). Ab 9 Tok/s gilt ein Modell im Benchmark als lauffähig. Auf Apple-Rechnern teilen sich Prozessor und Grafik den Speicher; für Modelle nutzbar sind rund 11 GB von 16 GB und 36 GB von 48 GB.
M5 Pro · 48 GBMacBook Pro 16″86 Modelle gemessen
M1 Pro · 16 GBMacBook Pro 16″216 Modelle gemessen
M1 · 16 GBMacBook Pro 13″105 Modelle gemessen
| Modell | M5 Pro · 48 GB | M1 Pro · 16 GB | M1 · 16 GB |
|---|---|---|---|
| LFM2.5 8B 4,8 GB | 158,5 | 77,7 | 44,5 |
| Tiny Aya Water 2,0 GB | 94,8 | 43,4 | 18,3 |
| Gemma 3 4B 3,1 GB | 85,0 | 30,5 | 14,9 |
| Ministral 3 8B 5,6 GB | 46,8 | 18,9 | 8,9 |
| Qwen 3.5 9B 6,1 GB | 48,6 | 19,5 | 8,2 |
Tok/s, Durchschnitt aus eigenen Messungen · Stand 13.10.2026 · Strichlinie: 9 Tok/s, ab hier „lauffähig“
Das größte Modell, das noch flüssig läuft
Aus dem Benchmark · Reiter „Teilen“
Welche lokale KI was kann.
Diese Karten baut der Benchmark selbst, auf Knopfdruck und im Format für LinkedIn. Jede Zahl stammt aus eigenen Messungen, Stand 13.10.2026. Ein Klick vergrößert.
-

Familie · Mistral AI, Paris
Europa kann KI.
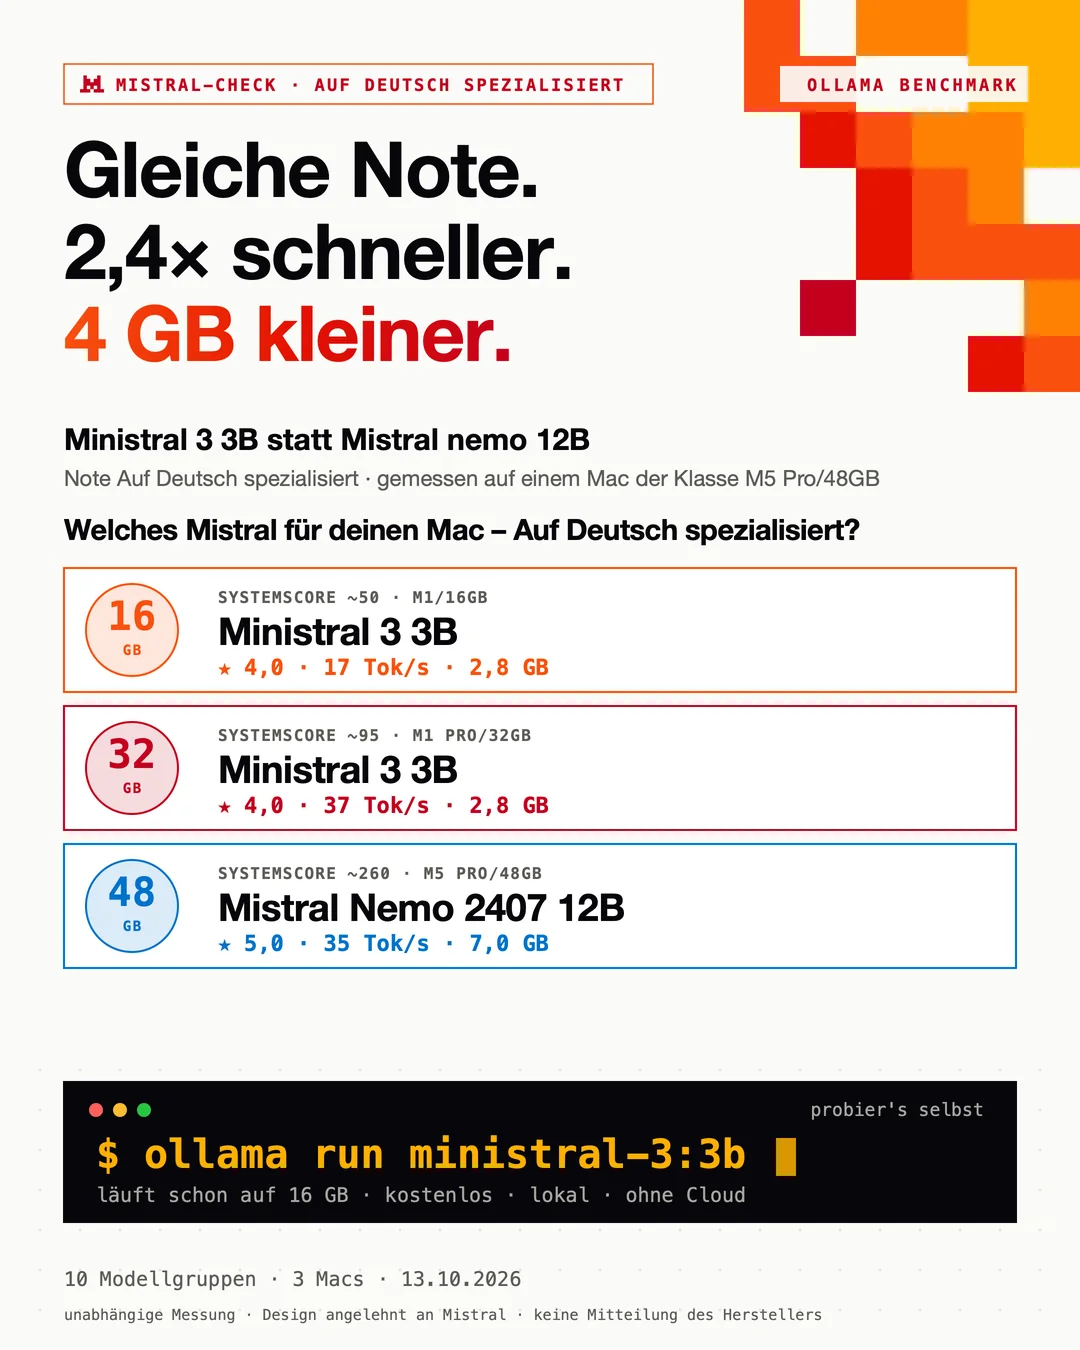
Ministral 3 3B erreicht auf Deutsch dieselbe Note wie Mistral Nemo 12B, ist dabei 2,4-mal so schnell und 4 GB kleiner und läuft schon auf 16 GB.
„Meine persönliche Anmerkung: Europäische KI muss sich nicht verstecken. Mistral und Ministral haben richtig gutes Deutsch drauf.“
-

Rangliste · Stil & Grammatik
Platz 2: selbst trainiert.
Direkt hinter einem 30B-Modell mit 17,8 GB landet Ferner Deutsch Stil v4, ein eigenes Modell mit 3,2 GB, trainiert auf gutes Deutsch.
-

Meine Wahl · Juristische Texte
Messung trifft Praxis.
Im Benchmark gewinnt ein Programmiermodell die juristische Textanalyse. Für die Arbeit an juristischen Texten ist meine Wahl Ministral 3 14B Instruct, wieder ein Modell von Mistral AI aus Paris, mit 8,5 GB und 35 Tok/s auf dem M5 Pro.
-

Familie · Qwen
Klein schlägt groß.
Für jede Modellfamilie zeigt der Benchmark, welches Modell auf 16, 32 oder 48 GB das beste ist. Hier schlägt Qwen 3 VL 2B das siebenmal größere Qwen 2.5 14B: bessere Note, 6,4-mal so schnell.
-

Sicherheit · Schutzfilter
Der Pförtner.
Bevor ein Text ein Modell erreicht, prüft ihn der Pförtner auf eingeschleuste Anweisungen. Getestet mit 25 Angriffen und 84 harmlosen Texten je Modell: 7 von 18 bestehen, der Sieger erkennt alle Angriffe ohne einen Fehlalarm.
-
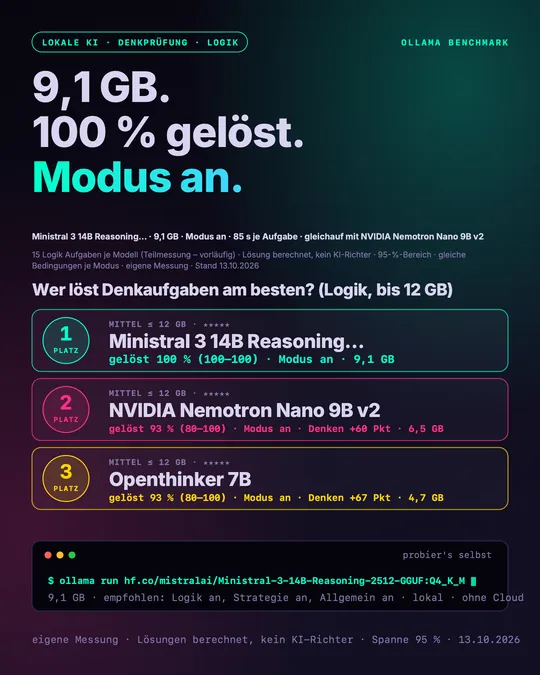
Denkprüfung · Logik bis 12 GB
100 % gelöst.
15 Logikaufgaben je Modell, die Lösung wird ohne KI-Richter nachgerechnet. Ministral 3 14B im Denkmodus löst alle (Teilmessung, vorläufig).
-

Meine Wahl · Zusammenfassen
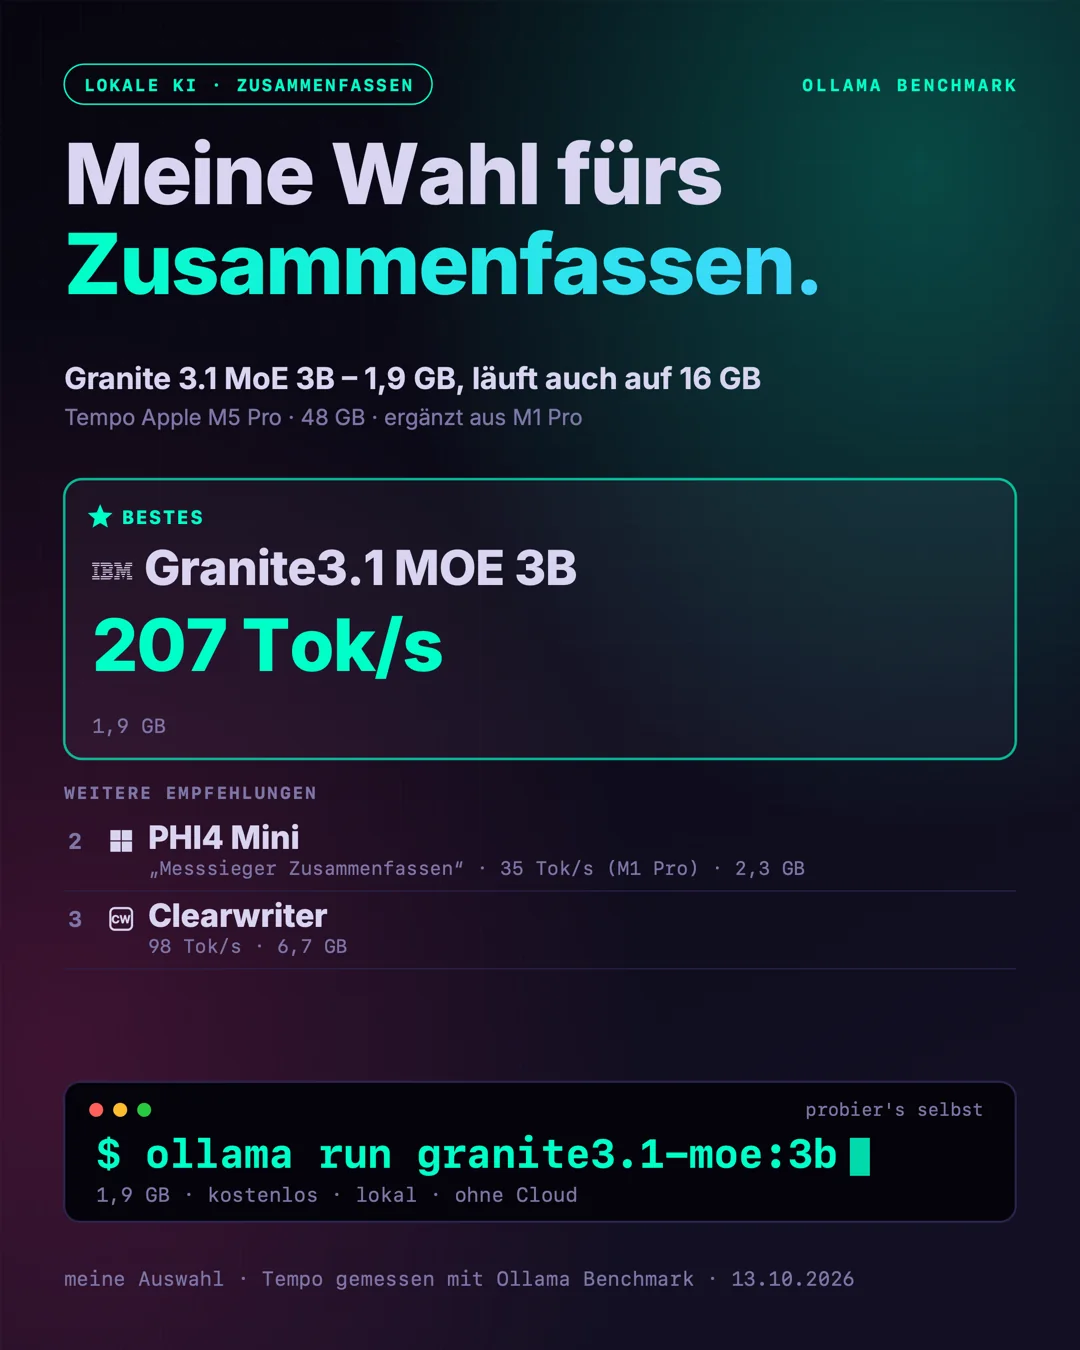
1,9 GB. 207 Tok/s.
Meine Wahl fürs Zusammenfassen ist Granite 3.1 MoE von IBM. Als Mixture-of-Experts-Modell rechnet es je Wort nur mit einem Teil seiner Gewichte und erreicht so 207 Tok/s auf dem M5 Pro, selbst auf dem M1 mit 16 GB noch 51 Tok/s.
-
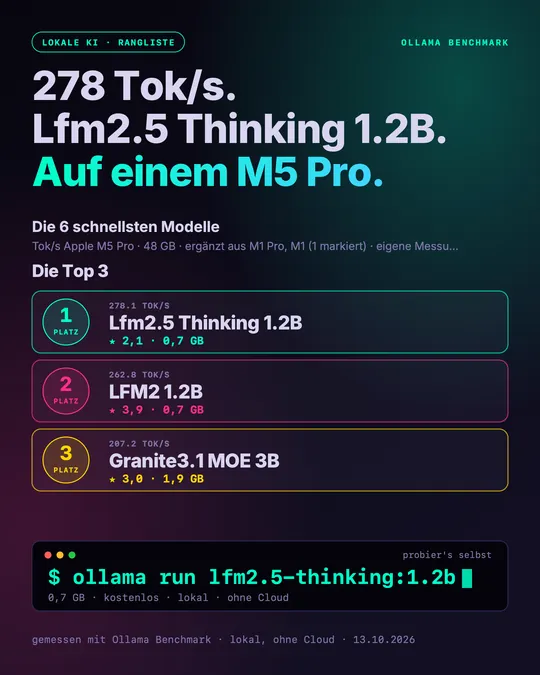
Rangliste · Tempo
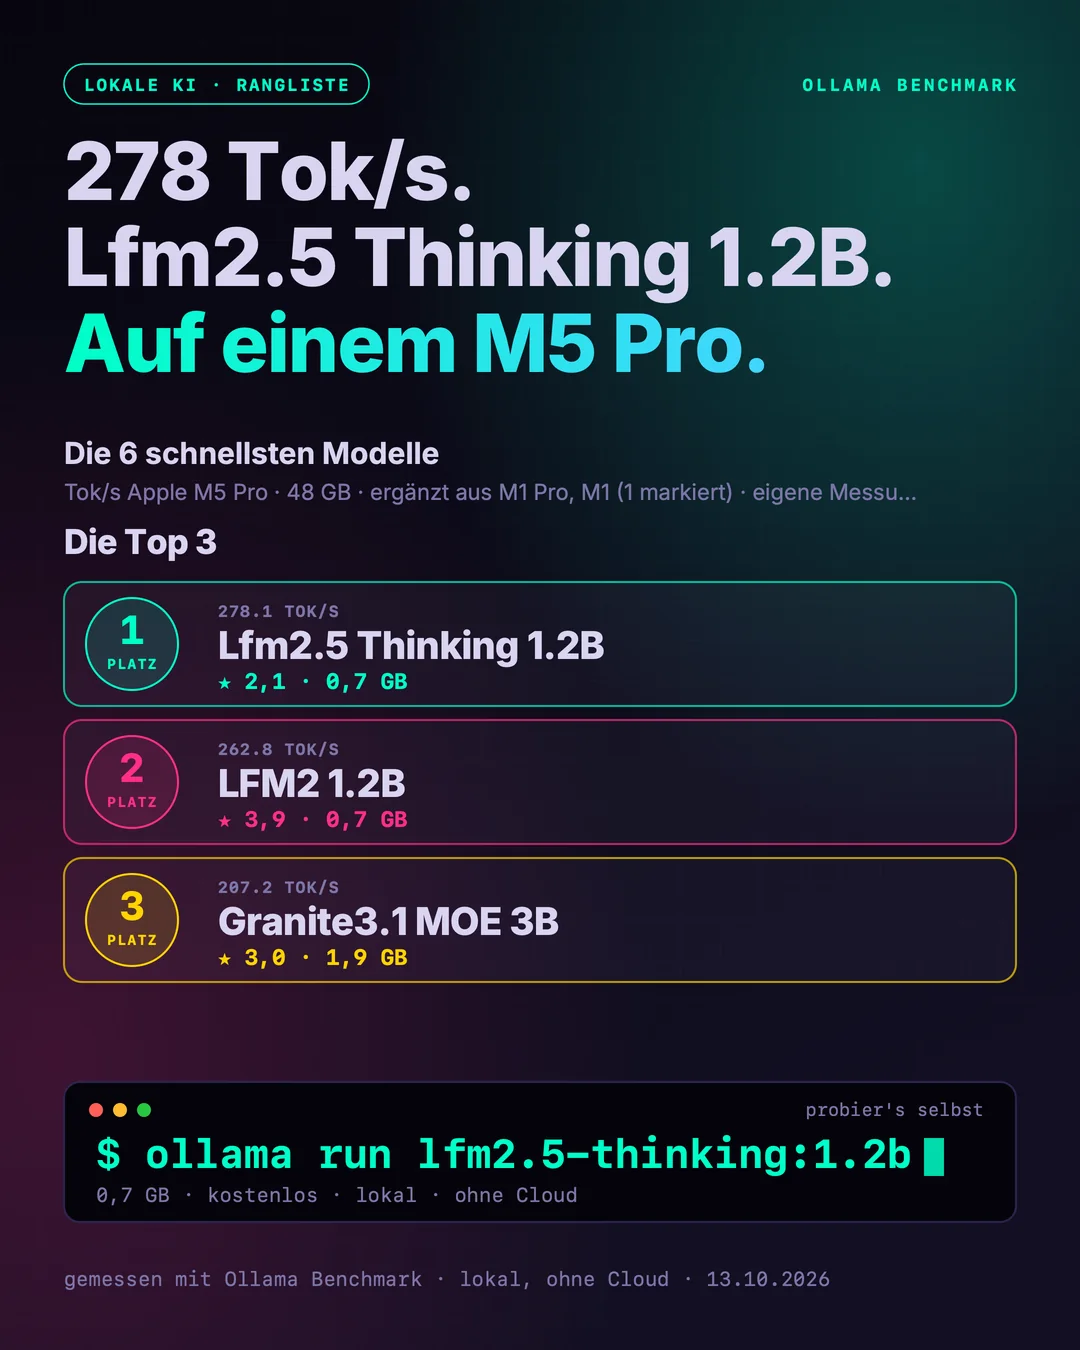
278 Token pro Sekunde.
So schnell schreibt ein 0,7-GB-Modell auf dem M5 Pro, doch seine Note liegt bei 2,1 Sternen, und deshalb wählt der Orchestrator je Aufgabe.


Deutsch-Test · 59 Modelle
Deutsch, von Hand gelesen.
Vier Aufgaben je Modell: zusammenfassen, eine Mail schreiben, einen Text korrigieren und indirekte Rede im Konjunktiv bilden. Jede Antwort wurde von Hand gelesen und mit bis zu 25 Punkten je Aufgabe bewertet, gemessen am 5. November 2026 auf dem M5 Pro mit 48 GB.
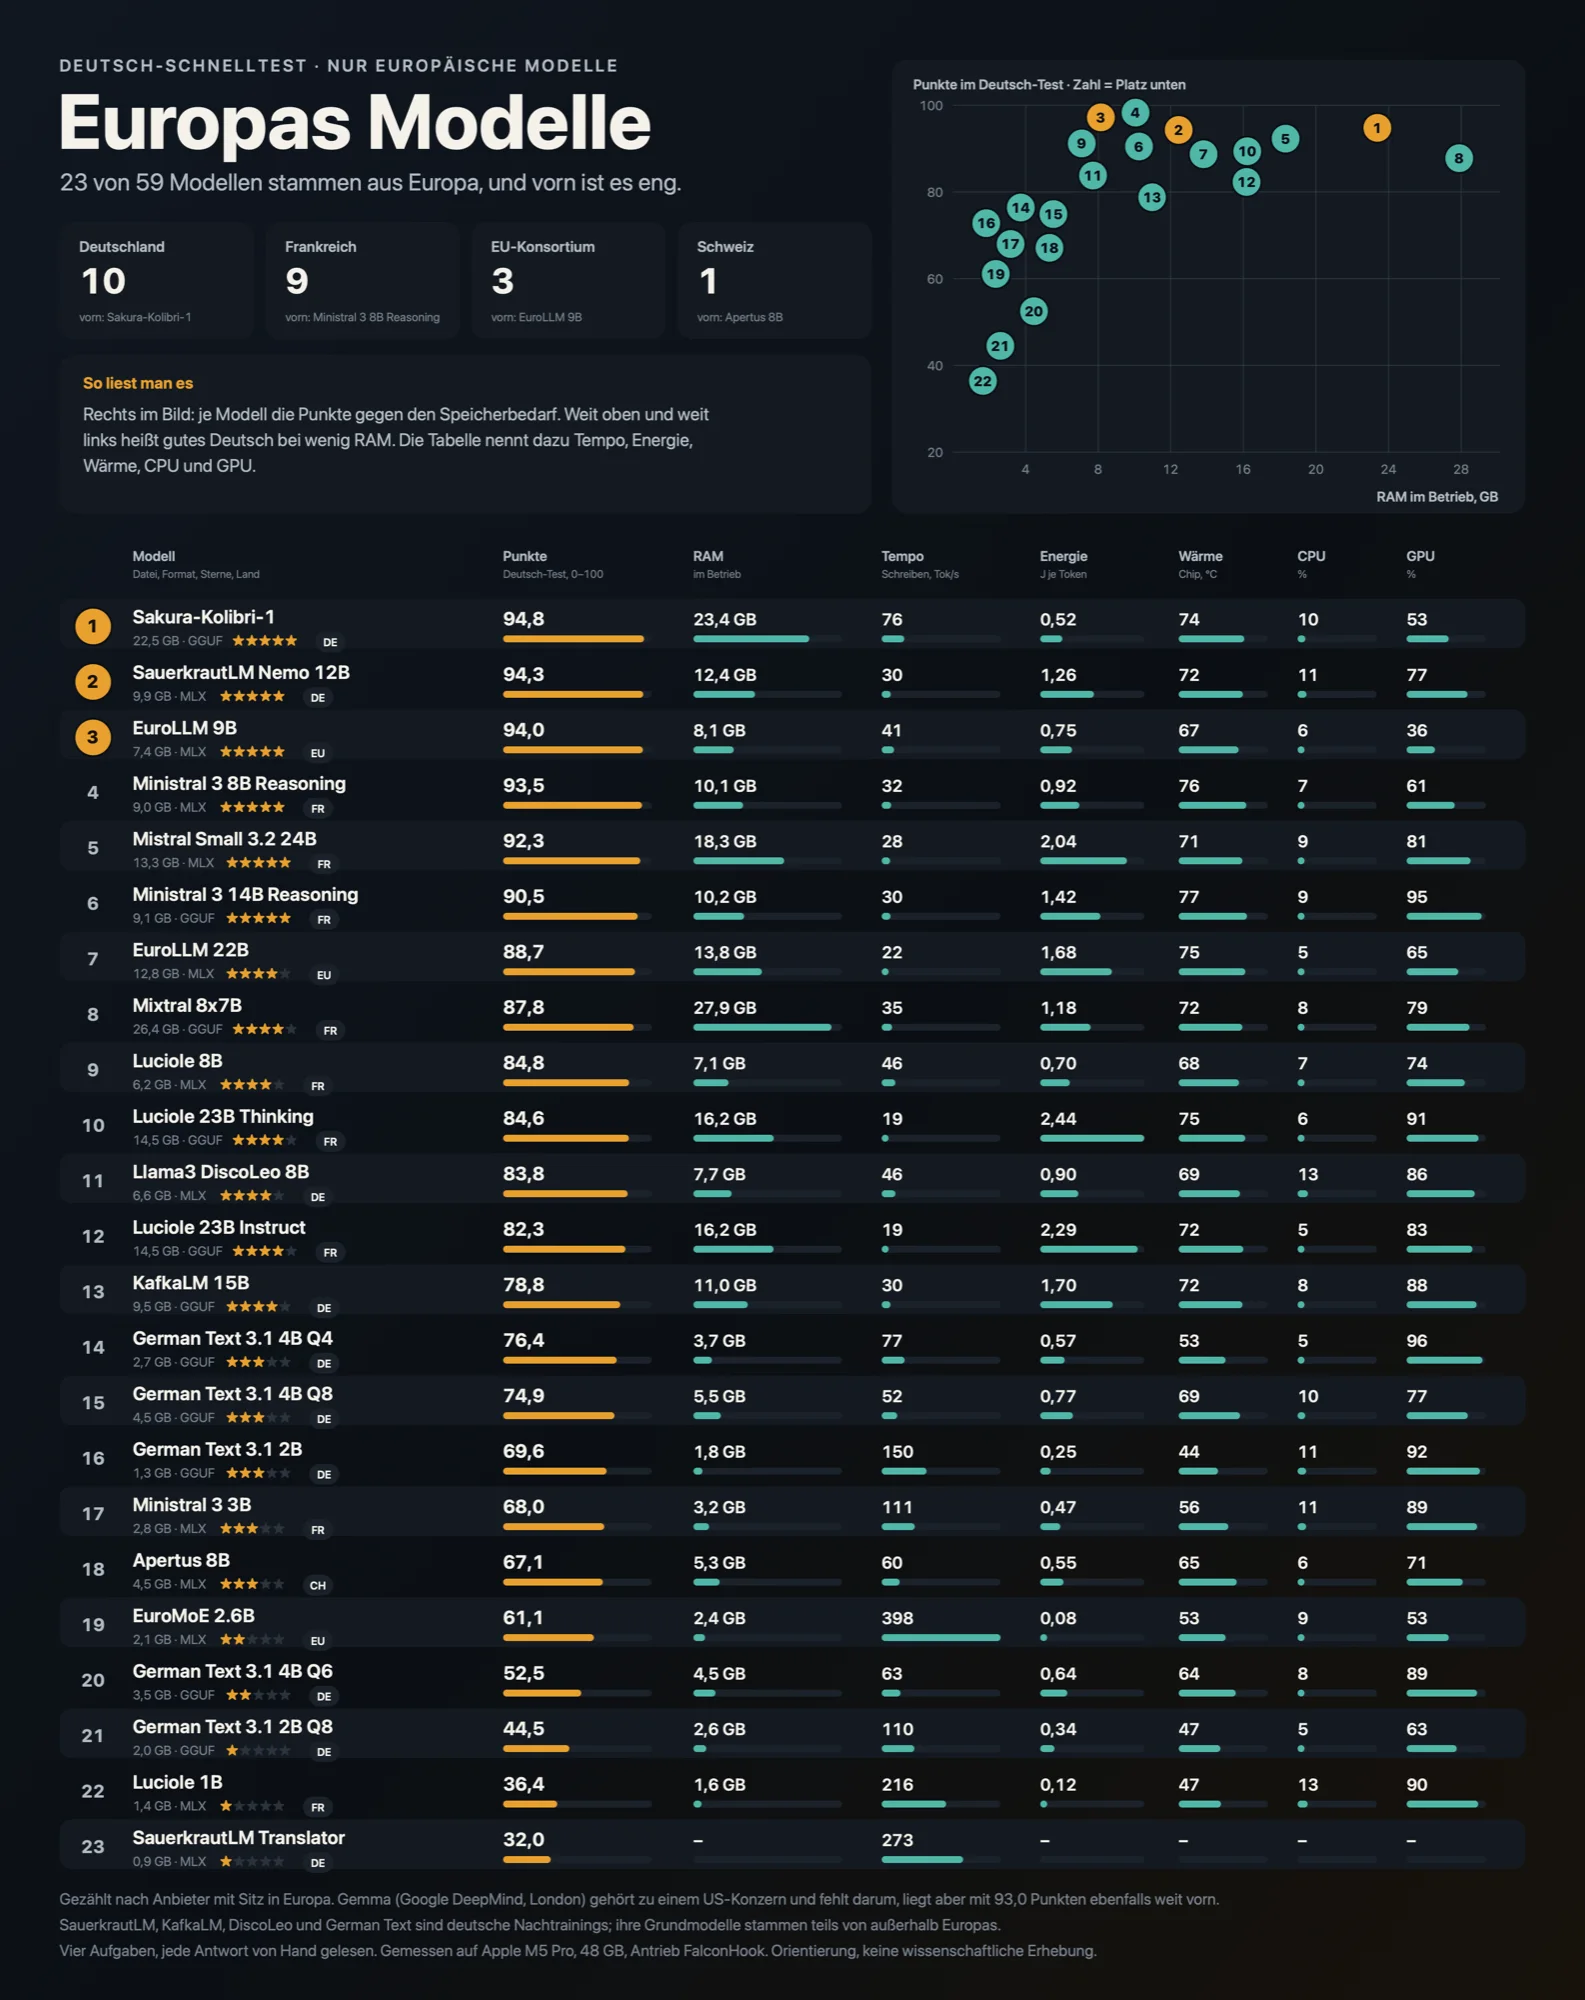
Den Test gewinnt ein deutsches Modell. Sakura-Kolibri-1 erreicht 94,8 von 100 Punkten, schreibt eine dichte Zusammenfassung in fünf Sätzen und eine knappe, fehlerfreie Mail und braucht dafür 0,52 Joule je Token. Dicht dahinter liegt EuroLLM 9B, ein Modell eines EU-Konsortiums, mit 94,0 Punkten bei nur 7,4 GB; seine Korrektur stimmt Buchstabe für Buchstabe mit der Musterlösung überein. Luciole 8B aus Frankreich kommt mit 6,2 GB auf 84,8 Punkte und setzt den Konjunktiv fast lehrbuchreif. 23 der 59 Modelle stammen aus Europa, und an der Spitze ist es eng.
Eine Rangliste misst allerdings nur, was sie misst: Beim treuen Umschreiben eines vorgegebenen Textes landet Kolibri auf Rang 4, und gutes Deutsch sagt noch nichts darüber, ob eine Aussage stimmt. Deshalb wählt der Orchestrator je Aufgabe.
| Modell | Punkte | Tok/s | J/Token |
|---|---|---|---|
| Sakura-Kolibri-1 DE · 22,5 GB | 94,8 | 76 | 0,52 |
| SauerkrautLM Nemo 12B DE · 9,9 GB | 94,3 | 30 | 1,26 |
| EuroLLM 9B EU · 7,4 GB | 94,0 | 41 | 0,75 |
| Ministral 3 8B Reasoning FR · 9,0 GB | 93,5 | 32 | 0,92 |
| Mistral Small 3.2 24B FR · 13,3 GB | 92,3 | 28 | 2,04 |
| Ministral 3 14B Reasoning FR · 9,1 GB | 90,5 | 30 | 1,42 |
| EuroLLM 22B EU · 12,8 GB | 88,7 | 22 | 1,68 |
| Mixtral 8x7B FR · 26,4 GB | 87,8 | 35 | 1,18 |
| Luciole 8B FR · 6,2 GB | 84,8 | 46 | 0,70 |
Punkte von 100 · Tok/s beim Schreiben · Energie in Joule je Token · M5 Pro 48 GB · Stand 05.11.2026 · SauerkrautLM ist ein deutsches Nachtraining eines Grundmodells von außerhalb Europas.
Energie
Ein Laptop, 13 bis 18 Watt.
Gemessen am 3. und 4. November 2026 auf einem MacBook Air (M4, 16 GB) am Netzteil, mit 15 Modellen beim Schreiben unter Volllast.
Gespart wird vor allem am Weg zur Antwort. Wer die Akte am Stück übergibt oder fünf Fragen als ein Gespräch stellt, braucht für dasselbe Ergebnis 30 bis 71 Prozent weniger Energie, und bei der ganzen Akte fand das Modell sogar vier statt zwei von vier Fakten.

15 Werkzeuge · über 700.000 Zeilen Code
Alles selbst gebaut.
Benchmark v2 ist das Herz einer ganzen Werkstatt. Jedes Werkzeug fragt über eine gemeinsame Schnittstelle den Orchestrator und bekommt das passende Modell. Der Balken zeigt den Umfang des Codes.
- 229.000 ZeilenBenchmark & Orchestrator
Misst, benotet, wählt: Orchestrator, Pförtner, Arena und Leitstand.
- 185.000 ZeilenTextverarbeitung
Unsere eigene Textverarbeitung, im Browser und als App, mit KI-Reiter, Faktenchecker, Redakteur und Parascriba.
- 75.000 ZeilenLocalChat
Chat mit Orchestrator, Wächter und Belegprüfer.
- 43.000 ZeilenCybersecurity-Engineer
Erkennt Spyware an ihrem Verhalten statt an Signaturen, mit Netz-Wache und Live-Monitor.
- 31.000 ZeilenSoftwareentwickler
Lokaler Code-Assistent: programmiert mit, ohne eine Zeile in die Cloud zu schicken.
- 26.000 ZeilenDateiaufräumer
Liest eingehende Gerichtspost und benennt sie nach ihrem Inhalt.
- 24.000 ZeilenOCR-Werkstatt
Macht Scans durchsuchbar und Handschrift lesbar, als Markdown oder DOCX.
- 20.000 ZeilenPDF-Viewer
Schlanker PDF-Viewer, der Ermittlungsakten aufbereitet.
- 15.000 ZeilenAktenviewer
Findet die Fundstelle in fünf Sekunden statt in fünf Minuten, auch mitten in der Hauptverhandlung.
- 15.000 ZeilenÜbersetzer
Übersetzt Texte samt Fachbegriffen vollständig lokal.
- 14.000 ZeilenDiktat
Spracherkennung mit Whisper, Feinschliff durch ein lokales Sprachmodell.
- 7.000 ZeilenLLM-Trainer
Trainiert eigene Sprachmodelle per LoRA, mit Mac und PC im Verbund.
Eigene Textverarbeitung · 185.000 Zeilen
Unsere eigene Textverarbeitung. Mit KI, die das Haus nicht verlässt.
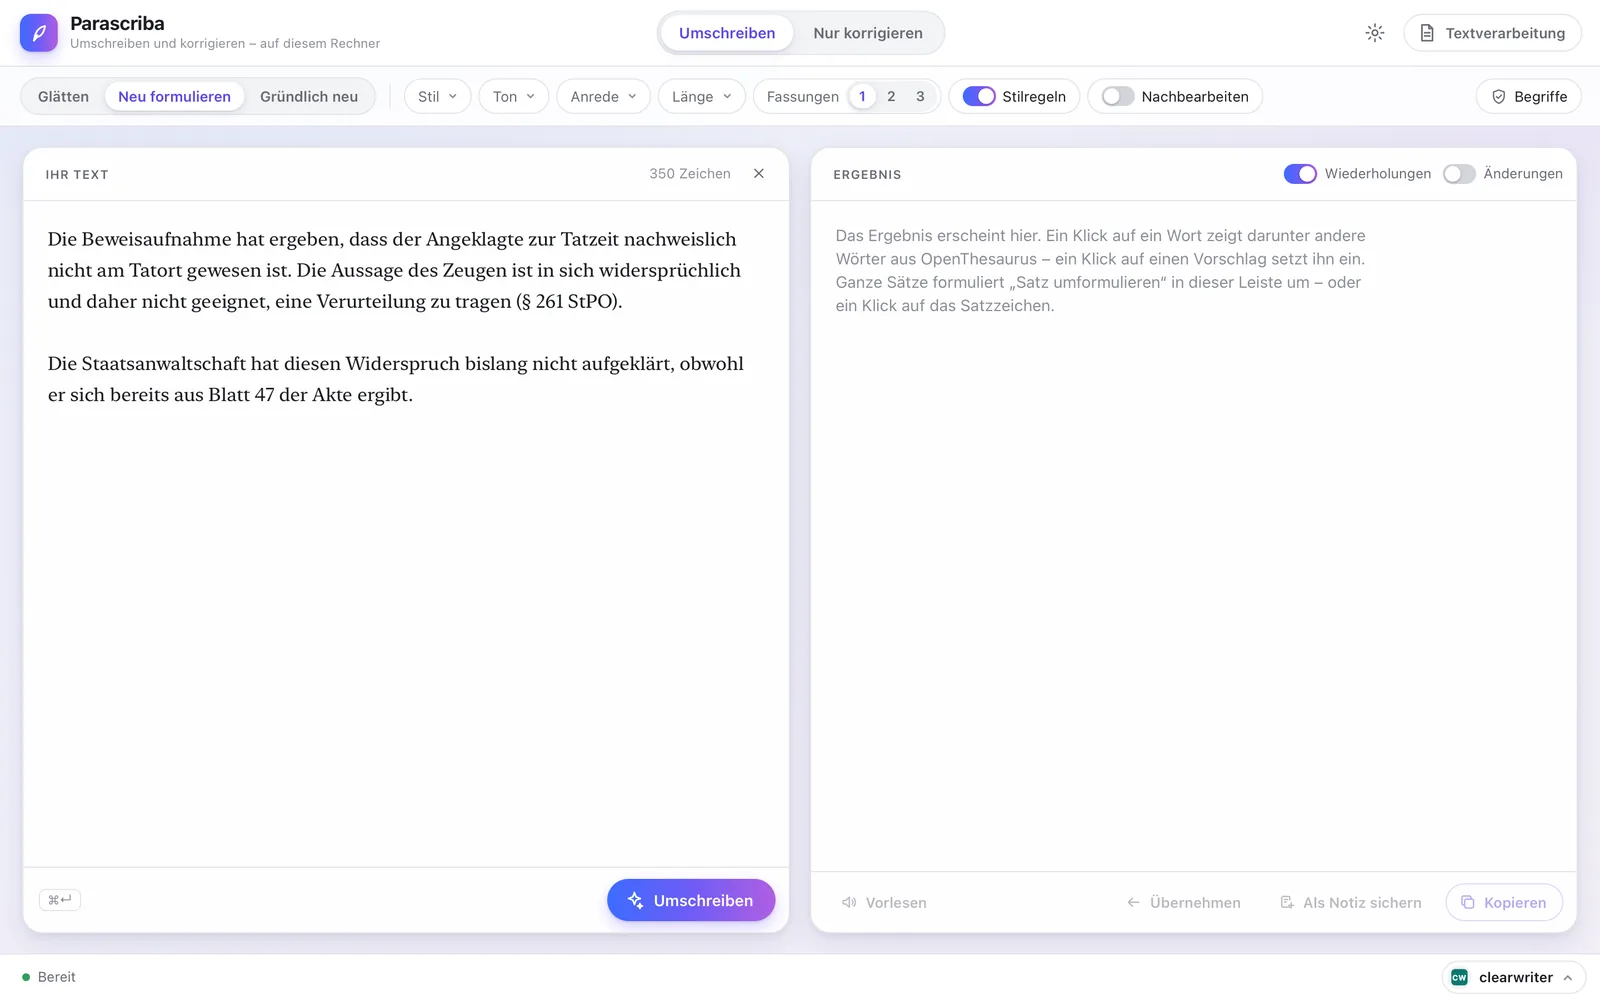
Selbst entwickelt, im Browser und inzwischen auch als eigene App. Sie öffnet DOCX-, RTF- und ODT-Dateien und speichert sie verlustfrei, mit Versionen, Fußnoten, Kommentaren, Formatvorlagen und gemeinsamem Schreiben im Heimnetz. Der Reiter KI prüft, überarbeitet, übersetzt und fasst zusammen, mit einem Faktenchecker und einem Redakteur, der juristische Fundstellen prüft. Welches Modell rechnet, entscheidet der Orchestrator.

Prüfen
- Faktenchecker
- Redakteur: prüft juristische Fundstellen (Entscheidungen mit Gericht, Datum und Aktenzeichen)
- Rechtschreibung, Grammatik, Stilkanon und Stilmaß
- Lektorat durch ein Sprachmodell als Anmerkungen am Text
Formulieren
- Parascriba: umschreiben und glätten, zugeschnitten auf juristische Texte
- Übersetzen und Zusammenfassen
Recherchieren
- Fragen an die eigenen Bestände, Archiv und Fachnews
- Ergebnisse mit Fundstelle – „Ins Dokument“ setzt sie als Fußnote
- ParaLex: Wörterbuch mit Synonymen, ganz ohne Netz
Schreiben
- DOCX, RTF, ODT und DOC – verlustfrei
- Version bei jedem Öffnen und Speichern: Nichts geht verloren
- Vorlagen mit KI entwerfen
- Läuft im Browser und als eigene App
Was Parascriba nie anfasst: Normzitate, Aktenzeichen, ECLI, wörtliche Zitate, Beträge und Daten gehen nur als Platzhalter an das Modell. Danach prüft Parascriba Zahlen, Verneinungen und Modalverben, damit aus „nicht“ nie „doch“ wird.
Selbst trainiert
Die Ferner-LLM-Familie.
Kleine Sprachmodelle, selbst trainiert auf gutes Deutsch mit Fokus auf Grammatik und Stil. Trainiert mit dem eigenen LLM-Trainer per LoRA: Der Mac plant, ein PC mit Grafikkarte rechnet, das fertige Modell läuft in Ollama.
$ ferner --steckbrief deutsch_stil_v4
- modell
- ferner_deutsch_stil_v4:2b
- ziel
- gutes Deutsch – Grammatik und Stil
- größe
- 3,2 GB · Q4_K_M
- kontext
- 131.072 Token
- note
- ★ 5,0 in Stil · Platz 2 der Rangliste
- training
- LoRA · eigener LLM-Trainer · Mac + PC
- v12,5 GB · erster Wurf, 60 Tok/s auf dem M1 Pro
- v2Denkmodus und 128.000 Token Kontext
- v3★ 5,0 für Deutsch
- v4★ 5,0 für Stil · Platz 2
Klare Grenzen
Was Benchmark nicht ist.
Benchmark v2 ist eine eigene Entwicklung von Jens Ferner – und bleibt es. Sie wird nicht zur Verfügung gestellt und niemals angeboten, weder als Software noch als Dienstleistung. Im Umgang mit Mandanten gibt es keine automatisierten Antworten. In der Mandatsarbeit kommt Benchmark nur zum Einsatz, wenn ein Unternehmen es für einen Vertragsentwurf ausdrücklich vereinbart; den Entwurf aus meinen eigenen Vorlagen prüfe und verantworte ich Satz für Satz.
Die Seite gibt es trotzdem, weil sie zeigt, wie ich arbeite: Ich verstehe Technik aus der Akte und baue sie selbst. Das zahlt sich aus, wenn es in einer Verteidigung um Chatverläufe, Datenträger, Metadaten oder Cybercrime geht.